 老雷AI实验室
别再开十个标签页做调研,一条命令打穿九个平台
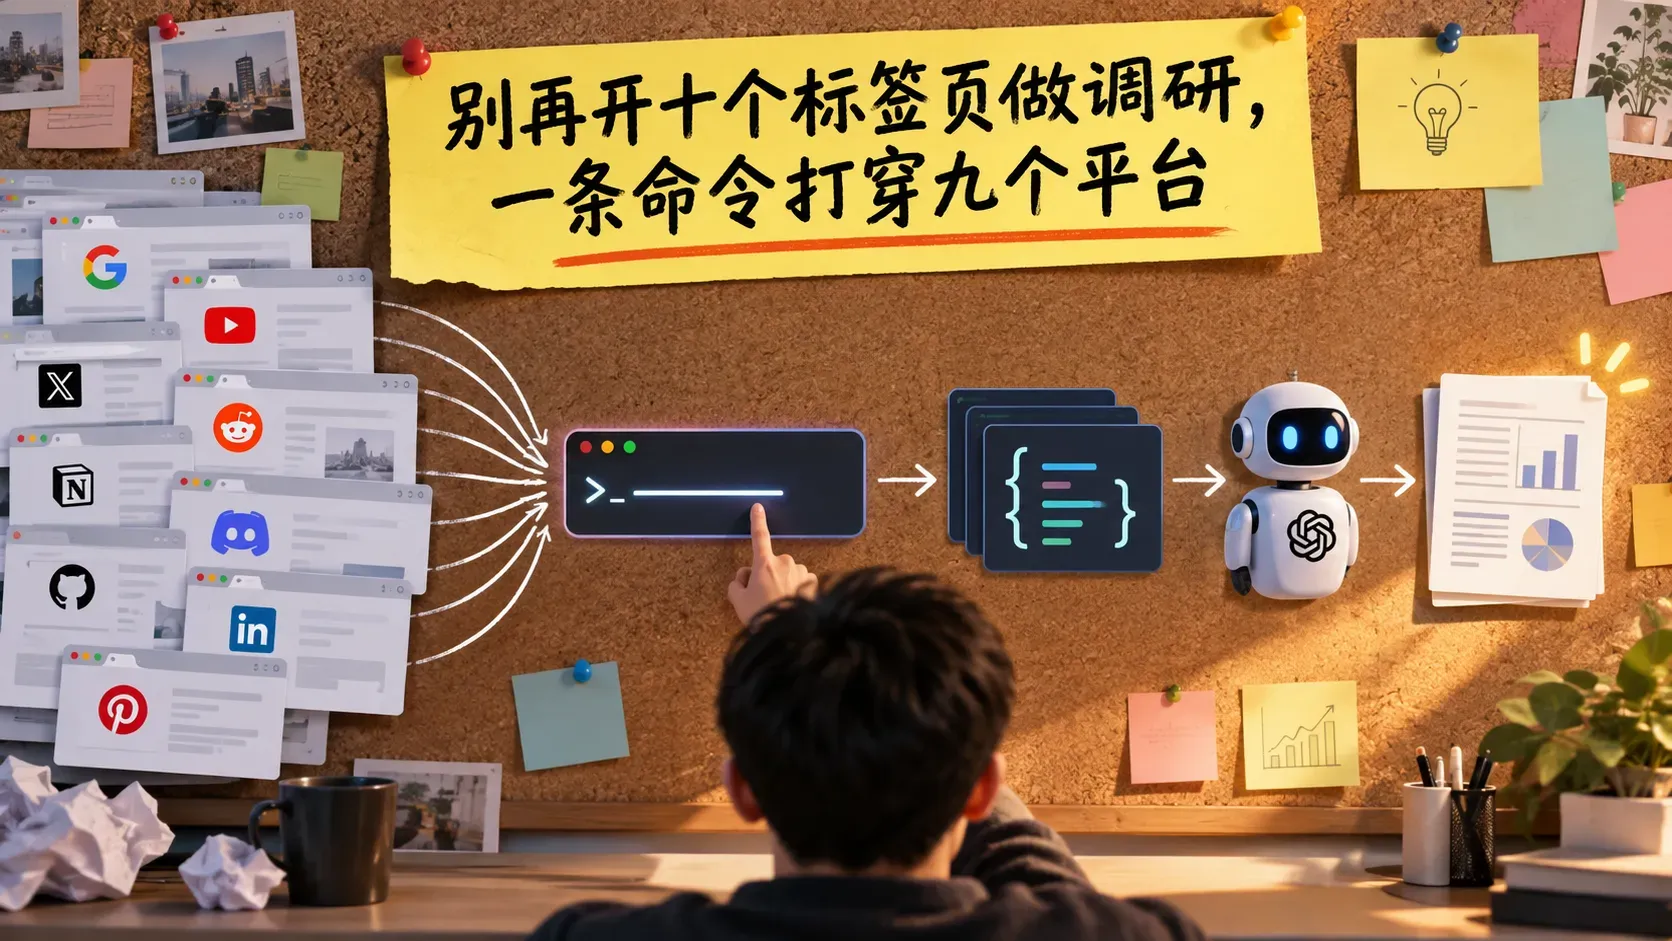
上个月做一个 AI Agent 选题,我按老习惯开工。打开视频网站看头部博主怎么讲,切到 X 看英文圈在吵什么,再切 Reddit、B 站、小红书、知乎,最后刷一遍抖音和 TikTok。一圈下来一个半小时,笔记没写几行,倒是被推荐流喂了十几分钟猫猫视频。
这还算顺利的。赶上一次账号风控,半天就交代进去了。
后来我把这件事翻出来重新想。做内容拆到底就三个动作,输入信息、加工信息、输出信息。大家把精力全砸在输出上,怎么写得更漂亮、剪得更抓人,输入这一步永远默认手动。可输入慢一倍,整条流水线就慢一倍,输入不全,加工再精彩也是空转。
所以我花了一个月,把输入这一步彻底重做了一遍。现在是一条命令,并行搜九个平台,五秒拿回一份统一格式的 JSON,直接塞给 Agent 生成调研报告。从那以后,那些平台我再没单独登录过。
输入才是内容生产的上限
先把这笔账算细。
手动做一个跨平台选题,你要在九个界面之间来回切换,记语法、等加载、复制粘贴,一个半小时起步。每个月做十个选题,光切平台就烧掉十几个小时。时间还只是表面损耗,更深的一层是注意力。你刚在 X 上搜完,手一滑刷了十分钟推荐,回过神来半小时没了。
每个平台的信息流都是为你设计的陷阱,做调研的人一不小心就变成被调研的人。
做内容的人,生产资料就是注意力。注意力被九个推荐算法轮流切菜,再聪明也写不出好东西。老雷这几年帮企业做内容产线,观察下来一个规律,产出上不去的团队,八成问题都出在输入这一环,而不是写作水平。
工具没把调研变得更快,工具把注意力还给了你本人。
我想明白这一点之后只问了自己一个问题,能不能一条命令把九个平台同时搜了。不登录、不记语法、不用防着自己刷推荐,结果直接吐一份 AI 能读的结构化数据。
CLI 管动作,Skill 管流程
动手之前先想清楚一件事,这东西该做成 CLI 还是 Skill。这个问题背后是 Agent 时代一个关键的分工。
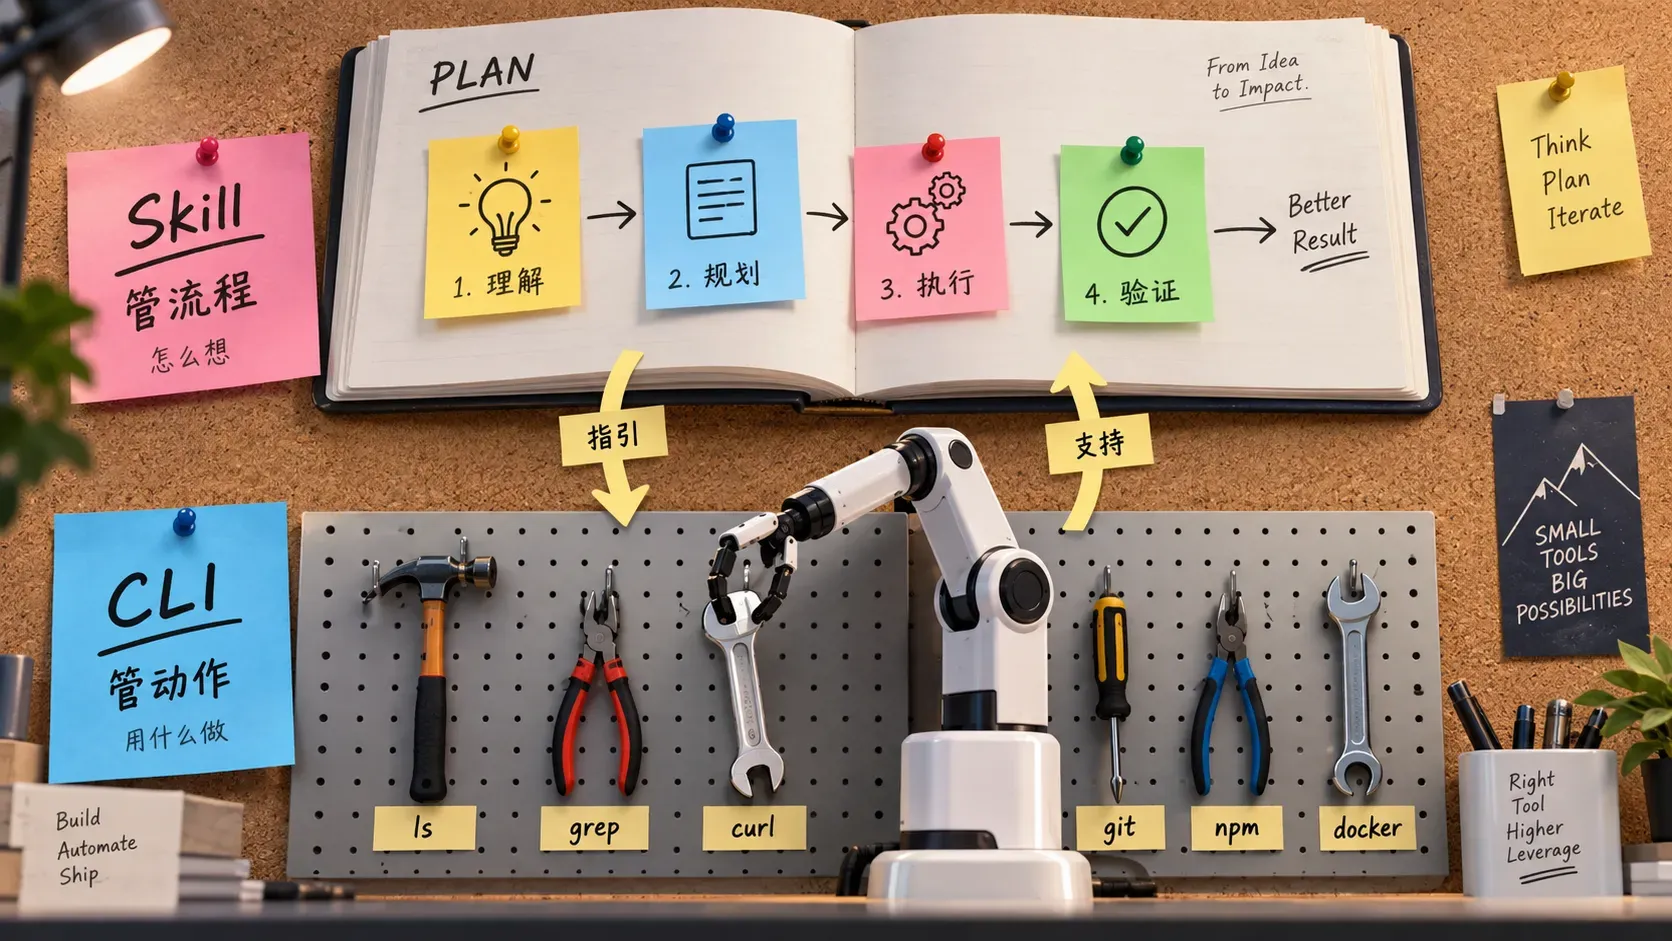
CLI 就是命令行工具,不开界面,终端里敲一条命令,它把结果吐回来。Skill 是给 AI 的工作手册,告诉它一类任务该按什么流程走。打个比方,Skill 管「怎么想」,CLI 管「用什么做」。写一篇要发的长文,选题、找素材、起草、精修、配图、发布,这套流程是 Skill 的事。流程里真去九个平台拿数据、真调模型改稿子,这些具体动作靠 CLI。
九平台搜索为什么做成 CLI,因为它本质是个动作,不是流程。吃进去关键词,吐出来结构化数据,结束。没有判断链,没有分支决策。放到分工图里看就清楚了,上层一个调研 Skill 负责编排,先调九平台搜索拿数据,再调模型总结观点,再调发布工具发成稿。底层每个 CLI 只做一件事,像乐高积木,九平台搜索是其中一块输入层积木,字幕提取、视频下载、一键发布各是各的一块。
老雷给大家提个醒,自己做工具前别先想「要做多大」,先想这件事是动作还是流程。动作就做 CLI,越专越好。流程就做 Skill,越完整越好。两者混在一起,最后两边都做得不伦不类。
一条命令,两个后端,九个平台
效果先摆出来。关键词和条数塞进去,五秒后终端返回一份统一格式的 JSON,九个平台各五条结果,字段对齐。塞给 Agent,它立刻能聚合、排序、生成调研报告。
架构上最关键的一个决策,不是做多少平台,是平台的访问限制不该由自己硬扛。我早期自己写过数据抓取脚本,抖音改版、小红书加验证、Ins 封号,每个月都在打补丁,半夜爬起来改代码是常事。后来换了思路,把数据获取外包给专业的数据服务商。
所以整套东西就两个后端。一家商业数据服务商的 API 覆盖其中八个平台,请求走他们的服务器和出口,不会封我本地这台机器。第九个是公开数据源,不用密钥。加起来一个密钥,打穿九家的访问限制,我这边零脚本维护。
入口是一条统一命令,底下每家平台还留了独立子命令,下载、字幕、评论、用户主页、热榜各有各的能力。一条命令是广度,各家 CLI 是深度。做调研走广度,做素材加工走深度,比如盯上一条视频想拿字幕做翻译,就单独调那家的字幕子命令。
六个坑,每个都是一次决策
这套东西打磨了一个月,踩的坑都不是技术细节,是决策问题。自己做类似的东西,这六条能省很多时间。
第一个坑,要不要统一入口。一开始我做的是九个独立 CLI,每家一个。用了两周发现不对,跨平台调研得一条一条敲,结果还是散的。Agent 经不起碎片化入口,九套参数学九遍,九次输出再聚合,Token 翻几倍精度还下降。后来在上面套了一层统一入口,Agent 只学一条命令,拿回一个 JSON。
第二个坑,虚拟环境怎么分。九个平台背后有六个后端,依赖互相打架。我本来想全塞一个环境,装了半小时还在解决冲突。后来改成每个后端独立虚拟环境,调度层零依赖,一家更新不影响其他,维护成本砍到地板。
第三个坑,从自用到能交付的跨度。最早这套东西只有我自己能用,路径写死了七处,密钥位置全凭记忆。后来做了三件事,硬编码路径清零,密钥改成三级加载,先读系统环境变量,再读项目配置,最后读本地凭据文件,每家平台补一份说明文档让 AI 读一眼就知道怎么调。自用工具和可交付工具的差距,不是功能差多少,是有没有把自己的痕迹清干净。
第四个坑,数据获取自己写还是外包。前面说了,外包。自己扛访问限制是无底洞,平台天天变,服务商靠这个吃饭,小钱换零维护,这笔账是划算的。
第五个坑,字段归一。九家返回的数据看起来像,字段名全不一样,小红书叫笔记,X 叫推文,点赞数有的叫 likes 有的叫 digg,时间戳有三种格式。我最早想让 Agent 自己解析,结果它调一次烧一次 Token,还老看错字段。后来在最上层加了一层归一,九家统一吐出标题、内容、作者、互动数、时间、链接六个字段,各家独有的塞进附加字段里要用再看。
第六个坑,一次拉几条。默认二十条跑了几天的结论是,前五条是热门,接着五条一般,后面十条全是噪声,Agent 读二十条和读五条结论差不多,Token 多烧四倍。改成默认五条,要深挖再翻页,Token 开销砍掉七成,调研质量反而更稳。
给 Agent 做工具,统一协议比加功能更重要,喂给它的不是越多越好,是越精越好。
谁该用,怎么用起来
这套东西我在几个场景里真跑过,对号入座。
自媒体选题调研,关键词扔进去,对比视频网站的角度、X 的论点、小红书的钩子,五秒完成原来四十五分钟起步的跨平台评估。社媒运营盯竞品,按账号拉最近内容清单,顺手下无水印素材、看评论区真实反馈,一个人盯五个账号的活压到十五分钟。跨境电商选品,同一个关键词按地区分别搜,北美看 Reddit 和 TikTok,东亚看小红书和抖音,拿回的互动数和发布时间直接让 AI 出市场分析。Agent 开发者装数据源,每家 CLI 都有自省子命令,输出机器可读的能力清单,Agent 解析一次就知道怎么调,统一 JSON 协议,九平台一次对接,不用手写九套适配。
判断标准就一条,你的工作只要涉及从多个渠道获取信息,这套打法都能把这一步压到极简。想起步的话,老雷的建议是别一上来铺九个平台,先挑你调研里最费时间的两三家,把统一入口和字段归一跑通,验证省下的时间真的够付数据服务的成本,再扩到全量。
回过头看,这一轮重做给我最大的收获不是快。是一条命令换掉了十个标签页,省下的不只是时间,是那种不再被九个推荐算法轮流切菜的清爽感。注意力回到了内容本身,这才是一件输入层工具真正的交付物。